Vector Database:如何在项目中进行向量数据库选型?
向量数据库选型
Openai 官方cookbook 推荐了一些向量数据库,我们本次使用最简单的 Chroma 快速体验下效果
https://cookbook.openai.com/examples/vector_databases/readme
AnalyticDB
Azure AI Search
Azure SQL Database
Cassandra/Astra DB
Chroma
Elasticsearch
Hologres
Kusto
Milvus
MyScale
MongoDB
Neon Postgres
Pinecone
PolarDB
Qdrant
Redis
SingleStoreDB
Supabase
Tembo
Typesense
Vespa AI
Weaviate
Zilliz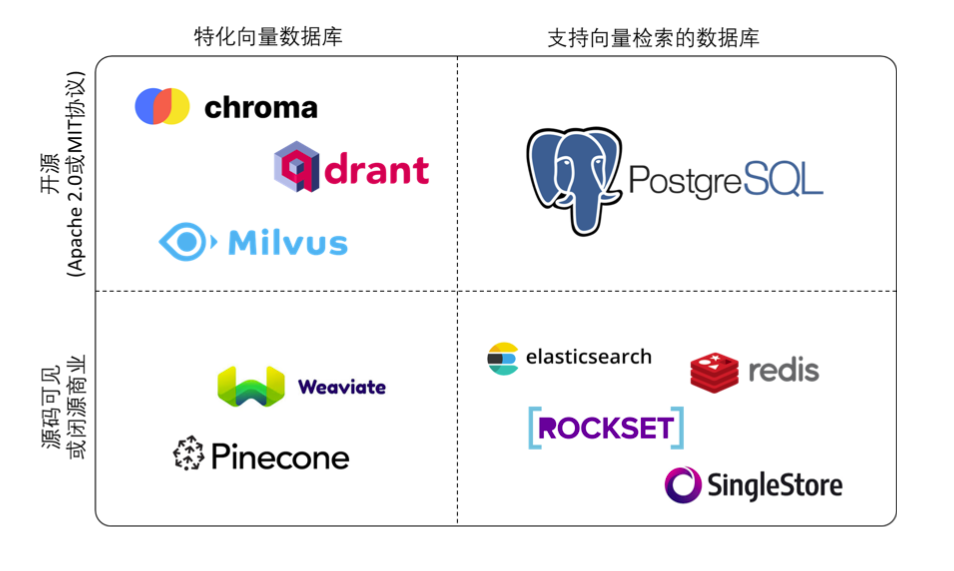
向量数据库对比:Milvus,Qdrant,Chroma,Weaviate
1、Milvus
- 核心优势:适合企业级大规模应用,毫秒级延迟(单查询<100ms,视索引和硬件,在高并发和大规模数据集(亿级向量)场景下表现优异,QPS 和召回率领先。2000万768维向量(HNSW索引),单机可达100-500 QPS,支持多种索引(HNSW、IVF、ANN-Bench测试中性能领先),可调参数(如efSearch)平衡速度和精度,资源消耗相对较高。
- 社区:由 Zilliz 开发,社区极为活跃,多语言 SDK(Python、Java、Go 等),API 丰富。地址:https://github.com/milvus-io/milvus ,34.2k stars(20250422)。
- 局限性:高并发下需分布式集群,单机QPS受内存和CPU限制。
2、Qdrant
- 核心优势:Rust语言开发的高效引擎,查询速度:毫秒级(<100ms),2000万向量约100-400 QPS,吞吐量:单机稍弱,分布式提升有限,成本考虑两者成本接近,Milvus性价比高,但是轻量,集成简单,AI框架支持好,内存和磁盘上的 HNSW 实现经过优化,性能稳定。
- 社区:社区增长迅速,文档和技术支持较好,REST 和 gRPC 接口,Python/JavaScript SDK 易用。地址:https://github.com/qdrant/qdrant ,23.1k stars(20250422)。
- 局限性:分布式性能不如 Milvus 稳定,在大规模数据集上的性能略逊于 Milvus,尤其在高并发场景下吞吐量有限。
3、Chroma
- 核心优势:主要在 Python 环境下工作,尤其是使用 LangChain 或 LlamaIndex。对小规模数据集(百万级以下)性能表现良好,查询延迟适中,适合快速原型开发。
- 社区:社区较小但活跃,轻量级,API 简单,适合新手和快速开发项目,文档简单明了。地址:https://github.com/chroma-core/chroma, 19.4k stars(20250422)。
- 局限性:无原生持久化存储,依赖外部数据库;超10亿向量时性能下降 40%。
4、Weaviate
- 核心优势:在中小规模数据集上性能表现良好,查询延迟较低,支持混合搜索(向量+关键词),水平扩展能力较强,可处理亿级向量,
- 社区:GraphQL 查询接口直观,Python/Go SDK 易用,文档详尽,社区支持良好。地址:https://github.com/weaviate/weaviate ,13.1k stars(20250422)。
- 局限性:GraphQL 有一定学习曲线。混合搜索和模块化虽然强大,但也增加了配置的复杂度。大规模扩展需要较多基础设施资源,成本可能高于 Qdrant。
5、其他
- Elasticsearch 太重,RedisVL 生态较弱,其他云平台的价格稍贵,不差钱的可以用一下。
对比:
作者:Ddd4j 创建时间:2024-05-04 22:56
最后编辑:Ddd4j 更新时间:2026-05-30 20:16
最后编辑:Ddd4j 更新时间:2026-05-30 20:16