Vector Database:向量数据库简介与应用场景
向量数据库是什么?
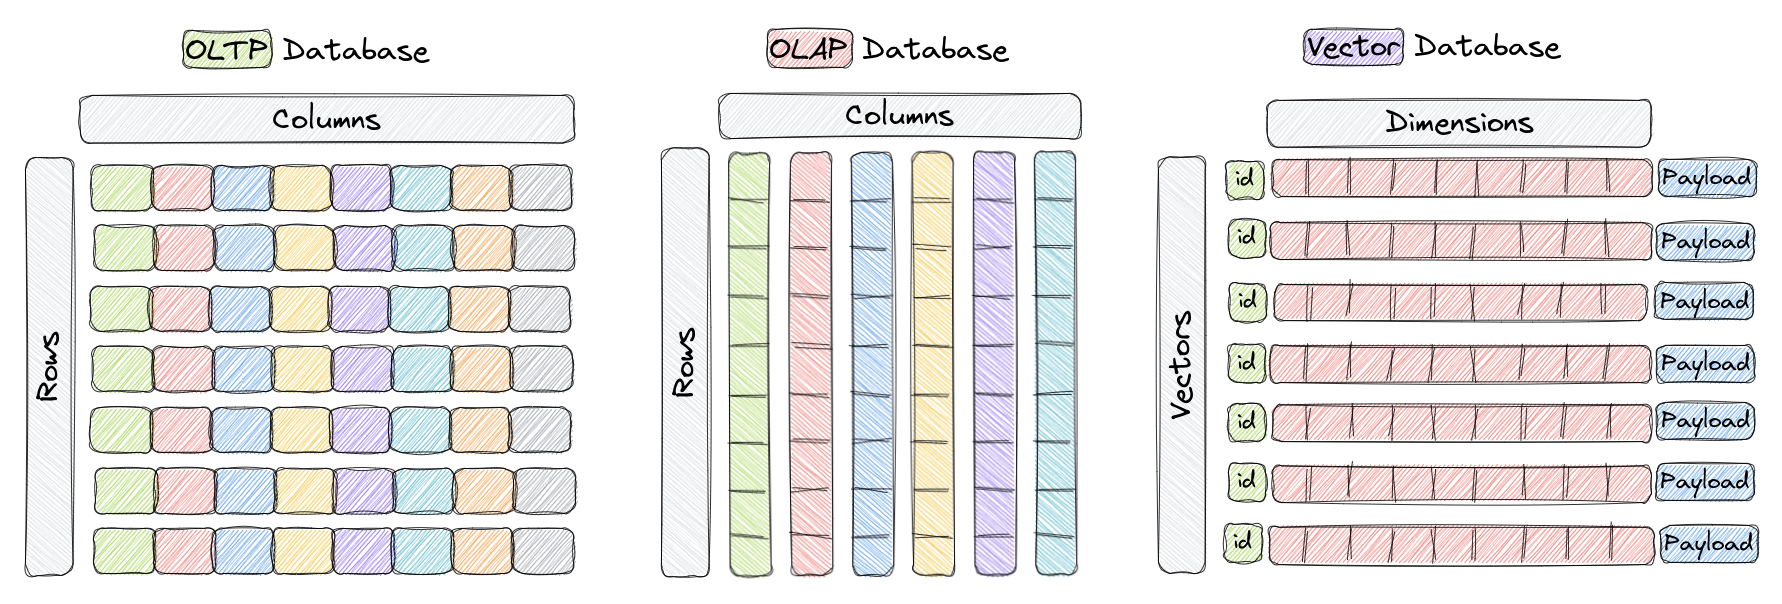
向量数据库是一类旨在高效存储和查询高维向量的数据库。在传统的OLTP和OLAP 数据库中(如上图所示),数据按行和列组织(这些称为表),并根据这些列中的值执行查询。然而,在某些应用程序中,包括图像识别、自然语言处理和推荐系统,数据通常表示为高维空间中的向量,这些向量加上 id 和 Payload,就是我们存储在称为 a 的元素中。
在这种情况下,向量是对象或数据点的数学表示,其中向量的每个元素对应于对象的特定特征或属性。例如,在图像识别系统中,向量可以表示图像,向量的每个元素表示像素值或该像素的描述符/特征。在音乐推荐系统中,每个向量代表一首歌曲,向量的每个元素代表一首特征歌曲,例如节奏、流派、歌词等。
向量数据库针对高效存储和查询这些高维向量进行了优化,并且通常使用专门的数据结构和索引技术,例如分层可导航小世界 (HNSW)(用于实现近似最近邻)和乘积量化等。这些数据库支持快速相似性和语义搜索,同时允许用户根据某种距离度量找到最接近给定查询向量的向量。最常用的距离度量是欧几里德距离、余弦相似度和点积,Qdrant 完全支持这三个距离度量。
以下是这三者的快速概述:
- 余弦相似度- 余弦相似度是衡量两个事物相似程度的一种方法。把它想象成一把尺子,告诉你两点相距多远,但它不是测量距离,而是测量两个事物的相似程度。它通常与文本一起使用,以比较两个文档或句子之间的相似程度。余弦相似度的输出范围为-1到1,其中-1表示两个事物完全不相似,1表示两个事物完全相同。这是比较两个事物的直接而有效的方法!
- 点积- 点积相似度度量是衡量两个事物相似程度的另一种方法,例如余弦相似度。它经常在机器学习和数据科学中处理数字时使用。点积相似度是通过将两组数字中的值相乘,然后将这些乘积相加来计算的。总和越高,两组数字越相似。因此,它就像一个尺度,可以告诉您两组数字彼此匹配的程度。
- 欧几里德距离- 欧几里德距离是一种测量空间中两点之间距离的方法,类似于我们测量地图上两点之间距离的方法。它是通过找到两点坐标之间的平方差之和的平方根来计算的。这种距离度量通常用于机器学习中,以测量两个数据点的相似或不相似程度,或者换句话说,了解它们之间的距离。
为什么我们需要矢量数据库?
向量数据库在需要相似性搜索的各种应用中发挥着至关重要的作用,例如推荐系统、基于内容的图像检索和个性化搜索。通过利用高效的索引和搜索技术,向量数据库可以更快、更准确地检索已经表示为向量的非结构化数据,这可以帮助向用户提供与其查询最相关的结果。
此外,使用矢量数据库的其他好处包括:
- 高维数据的高效存储和索引。
- 能够处理具有数十亿数据点的大规模数据集。
- 支持实时分析和查询。
- 能够处理源自复杂数据类型(例如图像、视频和自然语言文本)的向量。
- 提高机器学习和人工智能应用程序的性能并减少延迟。
- 与构建自定义解决方案相比,减少了开发和部署时间及成本。
请记住,使用向量数据库的具体好处可能会有所不同,具体取决于您组织的用例和您最终选择的数据库的功能。
为什么使用向量数据库
向量检索是一种基于向量空间模型的信息检索方法。将非结构化的数据表示为向量存入向量数据库,向量检索通过计算查询向量与数据库中存储的向量的相似度来找到目标向量。
1. 高效的数据检索
向量数据库通过使用向量(数值数组)来表示数据,这使得它们在处理大量复杂数据时表现出高效的检索能力。这种方法特别适合于机器学习和人工智能应用,其中数据的维度和复杂性要求更高效的检索算法。
2. 支持复杂查询
与传统的基于文本的数据库相比,向量数据库能够处理更加复杂的查询。例如,在图像识别或自然语言处理中,向量数据库可以快速地查找与给定图像或文本片段相似的项目,这在关系型数据库中是难以实现的。
3. 提高精度和相关性
通过使用深度学习模型将数据转换为向量,向量数据库能够更准确地捕捉数据之间的细微差别和关联。这意味着它们可以提供更相关和精确的搜索结果,这对于需要高度精准数据匹配的应用至关重要。
4. 灵活性和可扩展性
向量数据库的设计使得它们非常灵活和可扩展。它们可以轻松处理来自不同源的各种类型的数据,并且可以根据需要进行扩展以处理更大规模的数据集。
5. 促进创新
向量数据库的这些特性使其成为推动各种创新应用的强大工具。无论是推荐系统、智能搜索引擎还是先进的分析工具,向量数据库都提供了一种更高效、更准确的方法来处理和分析数据。
最后编辑:Ddd4j 更新时间:2026-05-30 20:16