Vector Database:Chroma 简介和应用场景
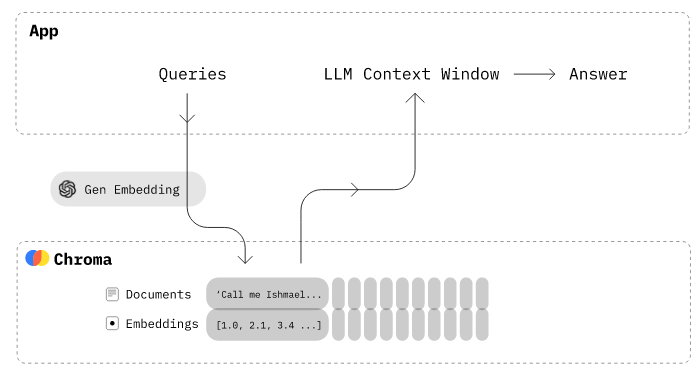
Chroma 是一个AI本地的开源嵌入式数据库,它提供了一套简单的工具来使用嵌入式数据。
它支持用于搜索、过滤等的丰富功能,并能与多种平台和工具(如LangChain, LlamaIndex, OpenAI等)集成。
Chroma 的 核心API 包括四个命令,用于创建集合、添加文档、更新和删除,以及执行查询。
- Github:
- 文档:https://docs.trychroma.com/
安装
pip install chromadb
pip install requests
pip install beautifulsoup4
数据准备
数据处理的流程是数据下载,数据切片,向量计算,相似度查找(召回),数据投喂,获取结果。
微信公众号内容下载
微信公众号内容下载
亦仁:东方甄选的危,是新的起飞机会;我是怎么搭建初创团队的?
我们使用作为案例进行数据下载和切分:https://mp.weixin.qq.com/s/IphmeueRlm8zEBPGMsjABg
from typing import List
from bs4 import BeautifulSoup
import requests

def get_text_chunks_from_url(url: str, max_chunk_size: int = 500) -> List[str]:
    def split_text(content: str, max_size: int) -> List[str]:
        chunks_ = []
        length = len(content)
        start = 0
        while start < length:
            end = start + max_size
            if end >= length:
                end = length
            chunk_ = content[start:end]
            chunks_.append(chunk_)
            start = end
        return chunks_

    response = requests.get(url)
    if response.status_code == 200:
        web_html_data = response.text
        soup = BeautifulSoup(web_html_data, 'html.parser')
        content = soup.find('div', class_='rich_media_content').text.strip()
        chunks = split_text(content, max_chunk_size)
        return chunks
    else:
        print('网页加载失败')
        return []
上面代码保存为 down_mp.py
相似度搜索
import uuid
import chromadb
from chromadb.utils import embedding_functions


from down_mp import get_text_chunks_from_url
# 指定embedding function使用openai接口能力
openai_ef = embedding_functions.OpenAIEmbeddingFunction(
    api_base="https://api.gptmini.ai/v1",
    api_key="sk-XXX",
    model_name="text-embedding-ada-002"
)

# 文件存储路径
client = chromadb.PersistentClient(path="/tmp/.chroma")
collection_name = "bf-mp-test"
client.delete_collection(collection_name)

collection = client.get_or_create_collection(name=collection_name, embedding_function=openai_ef)


chunks_from_url = get_text_chunks_from_url('https://mp.weixin.qq.com/s/IphmeueRlm8zEBPGMsjABg', 300)
for chunk in chunks_from_url:
    collection.add(
        documents=[chunk],
        metadatas=[{"mp": "生财有术"}],
        ids=[uuid.uuid4().hex],
    )
    print('add')

# 获取控制台输入
while True:
    print('请输入搜索内容')
    search_text = input()
    results = collection.query(
        query_texts=[search_text],
        n_results=2,
    )
    print('search')
    print(results)
    # {'ids': [['doc1', 'doc2']], 'distances': [[0.4450637689775306, 0.4570213244723775]], 'metadatas': [[{'source': 'notion'}, {'source': 'google-docs'}]], 'embeddings': None, 'documents': [['This is document1', 'This is document2']], 'uris': None, 'data': None}
    # 打印 2 个最相似的结果
    for i, result in enumerate(results['documents'][0]):
        print(f"Result {i}: {result}")
        print(f"Distance: {results['distances'][0][i]}")
        print(f"Metadata: {results['metadatas'][0][i]}")
        print(f"ID: {results['ids'][0][i]}")
        print()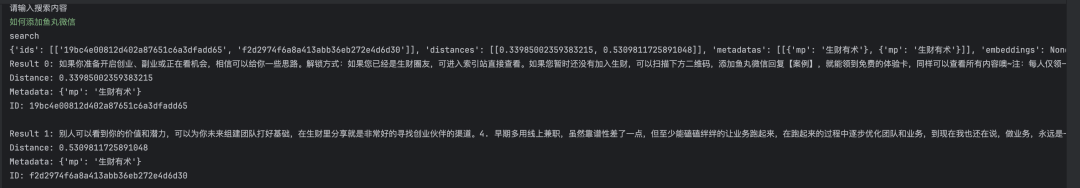
到此我们使用了如何使用向量数据库进行搜索。
作者:Ddd4j 创建时间:2024-04-05 23:14
最后编辑:Ddd4j 更新时间:2026-05-30 20:16
最后编辑:Ddd4j 更新时间:2026-05-30 20:16